Токены и токенизация: как языковые модели читают текст
Когда вы вводите предложение в языковую модель, она, как правило, не читает его как список обычных слов.
Сначала текст разбивается на более мелкие единицы — токены. Этот процесс называется токенизацией.
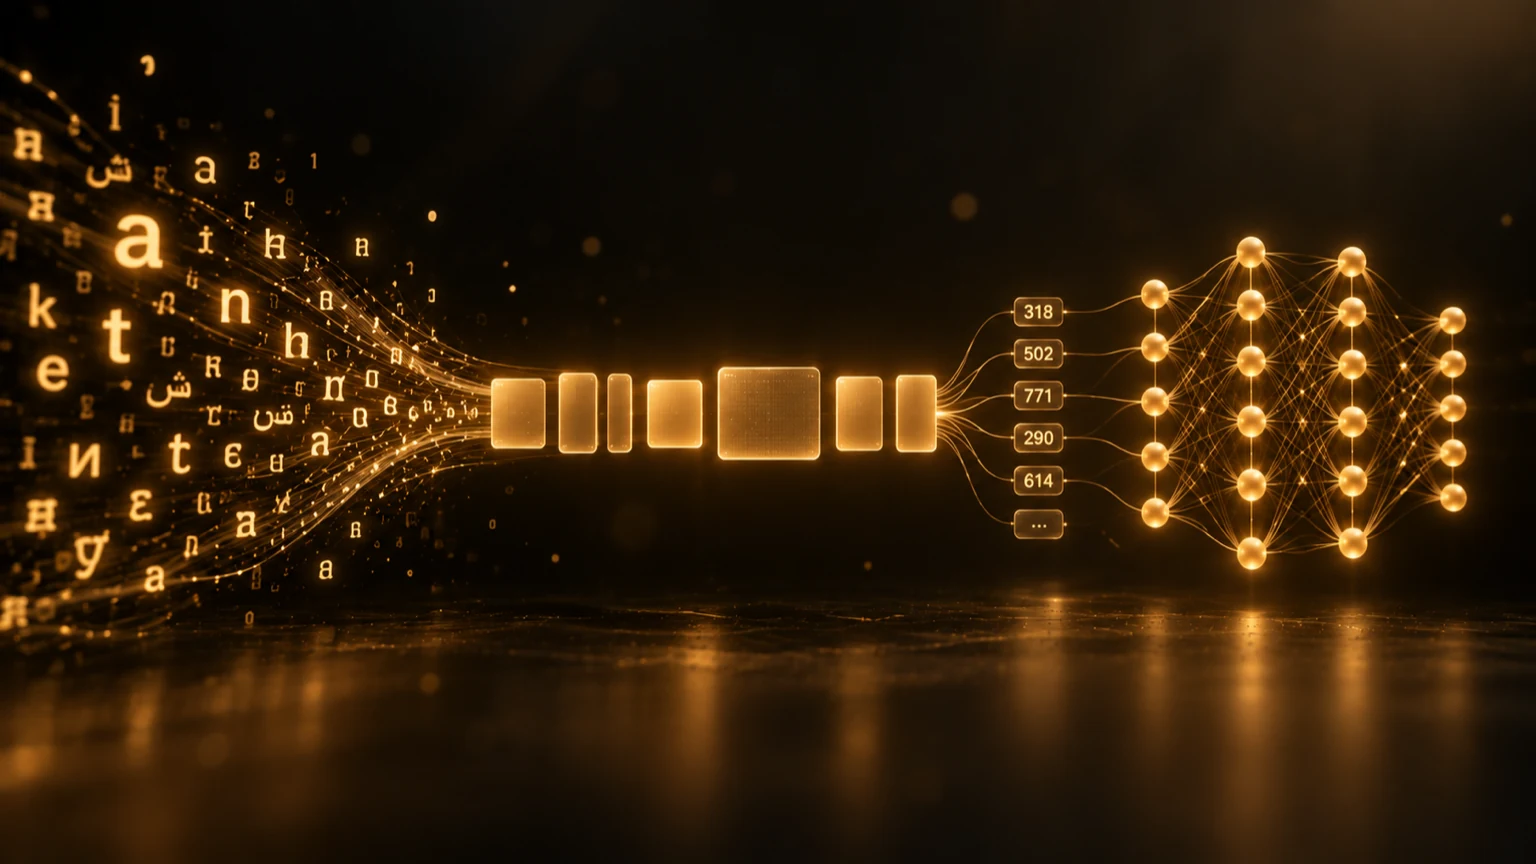
Упрощенно текст доходит до модели так:
- Вы пишете текст.
- Токенизатор разбивает его на токены.
- Каждый токен заменяется своим номером — token ID.
- Языковая модель обрабатывает эти числа.
Токены — один из базовых элементов современных языковых моделей. От них зависит, как представлен текст, сколько контекста может обработать модель, насколько быстро она работает, а нередко и то, как считается использование сервиса.
Что такое токен?
Токен — это единица текста, с которой работает модель. Токеном может быть:
- целое слово;
- часть слова;
- знак препинания;
- число;
- пробел вместе с соседними символами;
- а в некоторых токенизаторах — даже отдельный символ или последовательность байтов.
То есть токен — не то же самое, что слово.
В зависимости от токенизатора частое слово может быть одним токеном, а длинное или редкое — разбиваться на несколько частей. Например, один токенизатор может разделить английское слово tokenization на token и ization, а другой — разбить его иначе.
Главное: границы токенов определяет токенизатор, а не пробелы между словами.
Что такое токенизация?
Токенизация — это процесс преобразования обычного текста в токены, с которыми работает модель.
У токенизатора обычно есть словарь (vocabulary) — фиксированный набор фрагментов текста, которые он умеет представлять. У каждого токена в словаре есть числовой идентификатор — token ID.
Например, фраза «AI полезен.» условно может превратиться в четыре токена:
| Токен | Token ID |
|---|---|
| «AI» | 4210 |
| «полез» | 9132 |
| «ен» | 2801 |
| «.» | 13 |
Разбиение и числа приведены только для иллюстрации: реальные токены и ID зависят от конкретного токенизатора. Обратите внимание, что слово полезен распалось на две части. Почему это важно для разных языков, разберем ниже.
Сама модель работает с числами. Поэтому по token ID она находит выученные векторные представления — эмбеддинги, которые уже обрабатывает нейронная сеть.
Когда языковая модель генерирует текст, процесс идет в обратную сторону: модель предсказывает token ID, а токенизатор превращает их обратно в читаемый текст.
Почему нельзя просто использовать слова?
Идея выделять один токен на каждое возможное слово кажется простой, но создает несколько проблем.
В языках огромное количество слов, имен, технических терминов, вариантов написания и новых выражений.
Если бы каждому полному слову требовался отдельный токен:
- словарь мог бы стать слишком большим;
- редкие слова было бы трудно представлять;
- новые слова могли бы вообще отсутствовать в словаре;
- языкам с большим количеством словоформ потребовалось бы огромное число отдельных записей.
Использование только отдельных символов решает проблему неизвестных слов, но превращает обычный текст в очень длинную последовательность.
Поэтому современные языковые модели часто используют компромисс — subword-токенизацию.
Частое слово или его распространенная часть могут оставаться одним токеном, а редкое слово разбивается на более мелкие повторно используемые части. Так модель сохраняет управляемый размер словаря и при этом может представить почти любой текст.
Распространенные методы токенизации
Существует несколько способов построить токенизатор. В современном NLP часто встречаются три названия:
- BPE (Byte Pair Encoding): начинает с отдельных символов или байтов и раз за разом объединяет самую частую пару соседних фрагментов в новый токен;
- WordPiece: формирует словарь полезных частей слов и известен по моделям вроде BERT;
- Unigram: начинает с большого набора возможных фрагментов и оставляет те, которые вероятностная модель считает самыми полезными.
Для обычного читателя важнее не детали алгоритма, а основная идея:
Токенизатор выучивает или задает полезный набор фрагментов текста и всегда одинаково разбивает текст на эти фрагменты.
Поэтому разные семейства моделей могут использовать разные токенизаторы даже для одного и того же языка.
Почему одно предложение может иметь разное число токенов?
Потому что токенизация зависит от токенизатора.
У двух моделей могут быть разные словари. В одном токенизаторе частое слово уже есть как один токен, а другому приходится разбивать то же слово на две или три части.
Поэтому одна и та же строка может дать 8 токенов в токенизаторе A и 11 токенов в токенизаторе B, хотя видимый текст полностью одинаков.
Именно поэтому число слов и число токенов — не одно и то же.
Для обычного английского текста в некоторых токенизаторах один токен в среднем соответствует нескольким символам, но это лишь грубая оценка. Ее нельзя считать универсальным правилом для всех языков, систем письма и моделей.
Почему язык имеет значение?
Качество токенизации может заметно различаться между языками.
Токенизатор, созданный в основном на данных одного языка, может очень эффективно представлять этот язык, но разбивать слова другого языка на множество мелких частей.
Это особенно важно для языков с богатым словообразованием, другой письменностью, особыми знаками или слабым представлением в данных, на которых создавался токенизатор.
Узбекский — хороший пример. К одному корню может присоединяться множество суффиксов, узбекский текст пишут и латиницей, и кириллицей, а в нем встречаются разные апострофоподобные символы. Токенизатор, хорошо представляющий частые узбекские конструкции, может работать эффективнее, чем токенизатор, в словаре которого таких конструкций почти нет.
Это не только теория. Когда NeuronAI создавал MustaqiLLM, токенизатор был частью дизайна модели: опубликованная версия использует BPE-токенизатор на 48 000 токенов, специально адаптированный для узбекского языка.
Это показывает, что токенизатор — не просто незаметная техническая деталь. Для многоязычного и локального AI он является важной частью архитектуры модели.
Токены и контекстное окно
Языковая модель может обработать только ограниченный объем информации за один раз.
Этот предел обычно называется context window — контекстным окном и чаще всего измеряется в токенах, а не в словах.
Например, если модель поддерживает контекст в 128 000 токенов, в этот бюджет могут входить prompt пользователя, история диалога, системные инструкции, документы и другой текст, который модель должна учитывать.
Документ с меньшим количеством слов не всегда использует меньше токенов, особенно если сравниваются разные языки или токенизаторы.
Поэтому эффективная токенизация помогает вместить больше полезного текста в тот же контекстный бюджет.
Токены, скорость и стоимость
Токены важны и с практической стороны.
Во многих AI-сервисах использование частично измеряется количеством входных (input) и выходных (output) токенов.
Чем больше токенов, тем больше единиц должна обработать модель. Это может влиять на:
- время инференса;
- использование памяти;
- требуемые вычисления;
- стоимость API;
- объем информации, который помещается в контекстное окно.
Это не означает, что самый короткий prompt всегда лучший. Полезный и ясный контекст часто улучшает результат.
Практическая цель — убрать ненужный текст, сохранив информацию, которая действительно нужна модели.
Как токены работают в ответе LLM?
Большие языковые модели генерируют текст токен за токеном. Упрощенный цикл выглядит так:
- Модель читает токены prompt.
- Считает вероятность для каждого возможного следующего токена.
- Выбирается один токен.
- Он добавляется к последовательности.
- Цикл повторяется, пока ответ не будет готов: модель предсказывает следующий токен уже по удлиненной последовательности.
Именно это мы имели в виду в статье об LLM, когда писали, что языковая модель предсказывает следующий токен.
Полный ответ может состоять из сотен или тысяч таких шагов. Для человека итоговый текст выглядит непрерывным, но внутри модели он строился токен за токеном.
Всегда ли токены — это видимый текст?
Нет.
Некоторые системы используют специальные токены, которые не должны отображаться как обычный текст. Они могут обозначать:
- начало или конец последовательности;
- границы между сообщениями;
- разные роли в диалоге;
- padding — служебные токены, которые выравнивают последовательности по длине;
- другую управляющую информацию.
Конкретные специальные токены зависят от модели и токенизатора.
Поэтому фактическое число использованных токенов иногда включает больше, чем просто видимые слова prompt.
Является ли токенизатор частью модели?
Правильнее считать токенизатор компонентом, тесно связанным с моделью.
Токенизатор определяет словарь и назначает токенам ID. Во время обучения модель изучает внутренние представления, соответствующие этим ID.
Поэтому заменить токенизатор уже обученной модели не так просто, как поменять настройку обработки текста. Если меняется словарь, нарушается связь между token ID и выученными моделью эмбеддингами.
Поэтому токенизатор обычно выбирают до или во время разработки модели и не меняют просто так после обучения.
Понимает ли токенизация смысл?
Нет.
Задача токенизатора — разделить и закодировать текст. Ему не нужно понимать предложение так, как языковая модель пытается моделировать связи внутри него.
Например, токенизатор может разделить технический термин на несколько частей просто потому, что такое разбиение удобно для его словаря. Затем языковая модель в процессе обучения изучает связи между этими токенами.
Получается такое разделение труда:
- Токенизатор: текст → фрагменты-токены → token ID.
- Модель: представления токенов → выученные связи → прогноз.
Токенизация подготавливает язык для модели. Изучение закономерностей — задача самой модели.
Самый простой способ запомнить
Если запомнить только две мысли, пусть это будут:
Токен — это часть текста, с которой работает модель.
Токенизация — это процесс разбиения текста на такие части и преобразования их в ID.
Одной строкой: текст → токенизатор → токены → числа → модель.
Этот небольшой этап предварительной обработки имеет неожиданно большое значение. Он влияет на то, насколько эффективно модель работает с разными языками, сколько текста помещается в контекстное окно, как считается использование и как язык вообще попадает в нейронную сеть.
Прежде чем LLM сможет спрогнозировать следующий токен, токенизатор должен сначала определить, что именно считать токеном.