Что такое нейронная сеть? Как работают нейронные сети
Нейронная сеть — это модель машинного обучения, которая изучает закономерности в данных, передавая информацию через связанные слои небольших вычислительных элементов — нейронов или узлов. В обиходе ее часто называют просто нейросетью.
Нейронные сети лежат в основе многих технологий, которые сегодня ассоциируются с AI: распознавания речи, генерации изображений, языковых моделей, рекомендательных систем и современного синтеза голоса.
Основная идея проще, чем может показаться: данные поступают на вход, проходят через слои связанных нейронов, и на выходе получается результат.
Во время обучения сеть делает прогноз, измеряет ошибку и корректирует свои внутренние связи. Если повторять этот процесс много раз, модель постепенно учится полезным закономерностям.
Почему это называется нейронной сетью?
Название связано с аналогией с биологическими нейронами мозга.
В человеческом мозге огромное количество нейронов соединено между собой. Искусственные нейронные сети заимствуют общую идею большого числа простых элементов, работающих вместе, но они не являются цифровой копией мозга.
Искусственный нейрон — это, по сути, небольшая математическая операция. Он получает числа, объединяет их, преобразует результат и передает информацию дальше.
Сила нейронной сети заключается не в том, что один искусственный нейрон «умный», а в том, что множество нейронов связаны между собой по слоям и обучаются вместе.
Как устроена нейронная сеть?
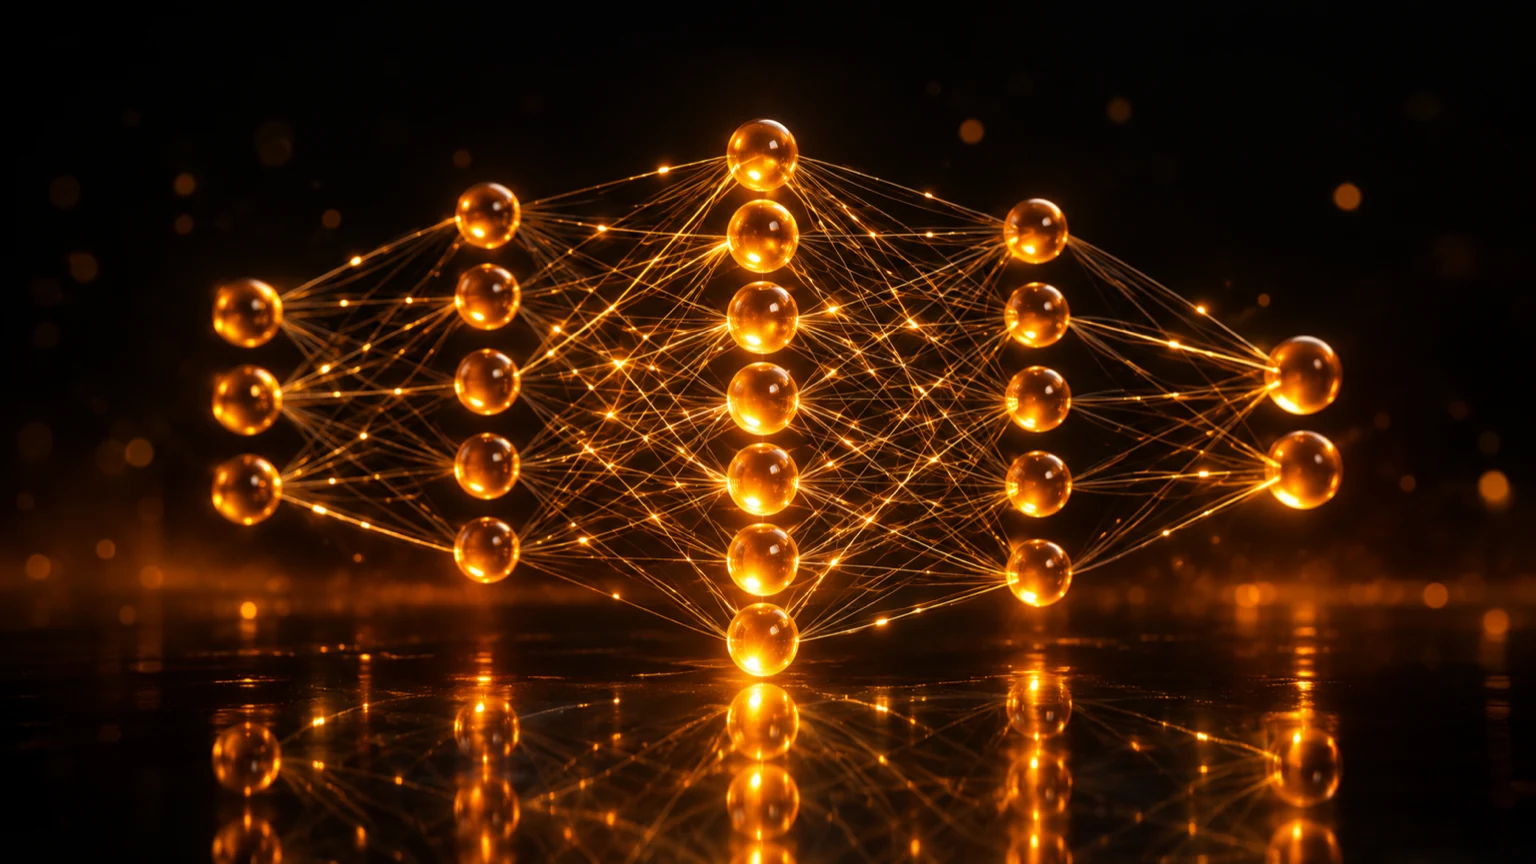
Базовая нейронная сеть обычно состоит из трех типов слоев: входного, одного или нескольких скрытых и выходного. Информация проходит через них именно в таком порядке.
Входной слой
Входной слой получает данные, которые подаются модели.
В зависимости от задачи входные данные могут представлять:
- пиксели изображения;
- измерения датчика;
- информацию о клиенте;
- фрагменты аудиосигнала;
- числа, представляющие слова или токены.
Нейронная сеть работает с числами, поэтому информацию из реального мира сначала нужно представить в числовом виде.
Скрытые слои
В скрытых слоях происходит основная обработка закономерностей.
Каждый нейрон получает значения из предыдущего слоя, выполняет вычисление и передает результат дальше.
Ранние слои могут изучать сравнительно простые признаки. Более поздние объединяют их в более сложные представления.
Например, в системе распознавания изображений ранние слои могут реагировать на края или простые формы, а более поздние — на комбинации признаков, помогающие распознать объект.
Выходной слой
Выходной слой формирует итоговый результат сети.
Он зависит от задачи. Например, это может быть:
- вероятность того, что на изображении есть кошка;
- прогноз следующего токена в предложении;
- число, например ожидаемая цена;
- класс «спам» или «не спам»;
- вероятности нескольких возможных речевых звуков.
Что на самом деле делает нейрон?
Нейрон получает на вход одно или несколько чисел.
Но не все входные значения одинаково важны. Поэтому нейронные сети используют веса.
Вес определяет, насколько сильно один сигнал влияет на последующее вычисление. Его можно представить как небольшой регулируемый коэффициент.
Упрощенно нейрон работает в четыре шага:
- Получает входные значения.
- Умножает каждое значение на его вес.
- Складывает результаты.
- Пропускает сумму через функцию активации и передает результат дальше.
Функция активации помогает сети изучать более сложные зависимости, чем простая линейная связь.
Чтобы понять основную идею, не нужно вручную считать эти операции. Важно лишь то, что внутри сети есть множество настраиваемых значений, а обучение определяет, какие их комбинации работают лучше.
Как нейронная сеть учится?
В начале обучения нейронная сеть обычно не знает правильного решения. Ее веса получают начальные значения, поэтому первые прогнозы могут быть неточными.
Обучение происходит в повторяющемся цикле:
- Дать сети пример.
- Получить прогноз.
- Сравнить прогноз с правильным ответом.
- Измерить ошибку.
- Скорректировать веса.
- Повторить.
Величину, используемую для измерения ошибки модели, обычно называют loss, или функцией потерь.
Цель обучения — уменьшать эту ошибку.
Метод обратного распространения ошибки (backpropagation) помогает определить, какой вклад каждый вес внес в ошибку. Затем алгоритм оптимизации обновляет веса так, чтобы будущие прогнозы становились лучше.
Этот процесс снова и снова повторяется на множестве примеров.
Сеть не просто запоминает список инструкций, написанных программистом. Она изучает полезные числовые закономерности в данных.
Простой пример: распознавание речи
Распознавание речи хорошо показывает, почему нейронные сети так полезны.
Предположим, человек говорит:
«Привет.»
Для компьютера запись изначально выглядит не как слово, а как меняющийся во времени аудиосигнал.
Нейронная сеть может обработать его через несколько уровней:
- Аудиосигнал
- Низкоуровневые звуковые закономерности
- Речевые признаки
- Вероятные звуки или токены
- Текст
Разные слои могут изучать разные уровни представления. Одна часть сети может реагировать на короткие акустические фрагменты, а более поздние части объединяют информацию во времени, чтобы определить наиболее вероятные звуки или слова.
Поэтому нейронные сети широко применяются в современных системах speech-to-text (STT).
Они используются и в других компонентах голосового AI. Современные системы text-to-speech (TTS) применяют нейронные модели для изучения произношения, темпа, интонации и генерации аудио. В NeuronAI технологии STT, TTS и языковые модели также объединяются в голосовых AI-сценариях — хороший пример того, как за простым для пользователя продуктом может работать сразу несколько нейронных моделей.
Поэтому когда система слушает речь, понимает язык и генерирует голосовой ответ, за одним простым пользовательским опытом могут одновременно работать несколько разных нейронных сетей.
Как это связано с глубоким обучением?
Нейронные сети и глубокое обучение тесно связаны, но это не совсем одно и то же.
Нейронная сеть — это общая структура модели.
Глубокое обучение обычно означает машинное обучение на основе нейронных сетей с несколькими слоями обработки и часто очень большим числом параметров.
Связь можно запомнить так:
- Машинное обучение — широкая область моделей, которые учатся на данных.
- Нейронные сети — одно из семейств моделей машинного обучения.
- Глубокие нейронные сети — нейронные сети с большим числом слоев.
- Глубокое обучение — построение и обучение таких глубоких сетей.
Современные большие языковые модели, продвинутые речевые системы и многие модели компьютерного зрения используют архитектуры глубоких нейронных сетей.
Слово deep здесь означает наличие нескольких уровней обучаемых преобразований, а не то, что модель «глубоко думает» как человек. Подробнее о разнице между этими терминами мы рассказали в статье AI vs ML vs DL.
Где используются нейронные сети?
Нейронные сети особенно полезны, когда связь между входом и выходом слишком сложна, чтобы описать ее несколькими вручную написанными правилами.
Типичные применения:
- речь: транскрибация, распознавание говорящего, синтез голоса;
- язык: перевод, суммаризация, чат-боты, большие языковые модели;
- компьютерное зрение: распознавание изображений, обнаружение объектов, генерация изображений;
- рекомендации: ранжирование товаров, видео, музыки или контента;
- прогнозирование: прогноз спроса, поведения и других числовых показателей;
- наука и инженерия: анализ сигналов, закономерностей и сложных наборов данных.
Особенно хорошо они работают, когда доступно большое количество полезных обучающих данных.
Всегда ли нейронная сеть — лучший выбор?
Нет.
Нейронные сети могут быть очень мощными, но у этого есть цена.
Им могут потребоваться:
- большие объемы обучающих данных;
- значительные вычислительные ресурсы;
- тщательная оценка;
- время и опыт для качественного обучения.
Для некоторых задач более простой метод машинного обучения может быть быстрее, дешевле, понятнее и при этом полностью достаточным.
Нейронные сети также ошибаются. Если обучающие данные плохого качества, несбалансированы или сильно отличаются от реальных данных, модель может выучить неверные закономерности.
Поэтому более крупная нейронная сеть не означает автоматически лучшее решение.
Думают ли нейронные сети как люди?
В обычном смысле слова «думать» — нет.
Нейронная сеть изучает математические зависимости между входными и выходными данными. Даже если ее поведение выглядит интеллектуальным, это не означает, что она понимает мир так же, как человек.
Аналогия с мозгом полезна для объяснения идеи связанных нейронов, но современные нейронные сети — это спроектированные математические системы.
Особенно важно помнить об этом при использовании языковых, голосовых или визуальных моделей в реальных продуктах. Уверенный прогноз все равно может оказаться ошибочным.
Самый простой способ запомнить
Если запомнить только одну мысль, пусть это будет следующая:
Нейронная сеть — это набор связанных вычислительных элементов, который учится на данных, изменяя силу своих внутренних связей.
Или еще короче: сеть делает прогноз, измеряет ошибку, корректирует веса и пробует снова.
Отдельные вычисления просты. Сила появляется, когда их много, они объединены вместе, а нужные параметры изучаются на данных.
Именно эта базовая идея лежит в основе огромной части современного AI — от распознавания устной речи до генерации текста, изображений и естественно звучащих голосов.