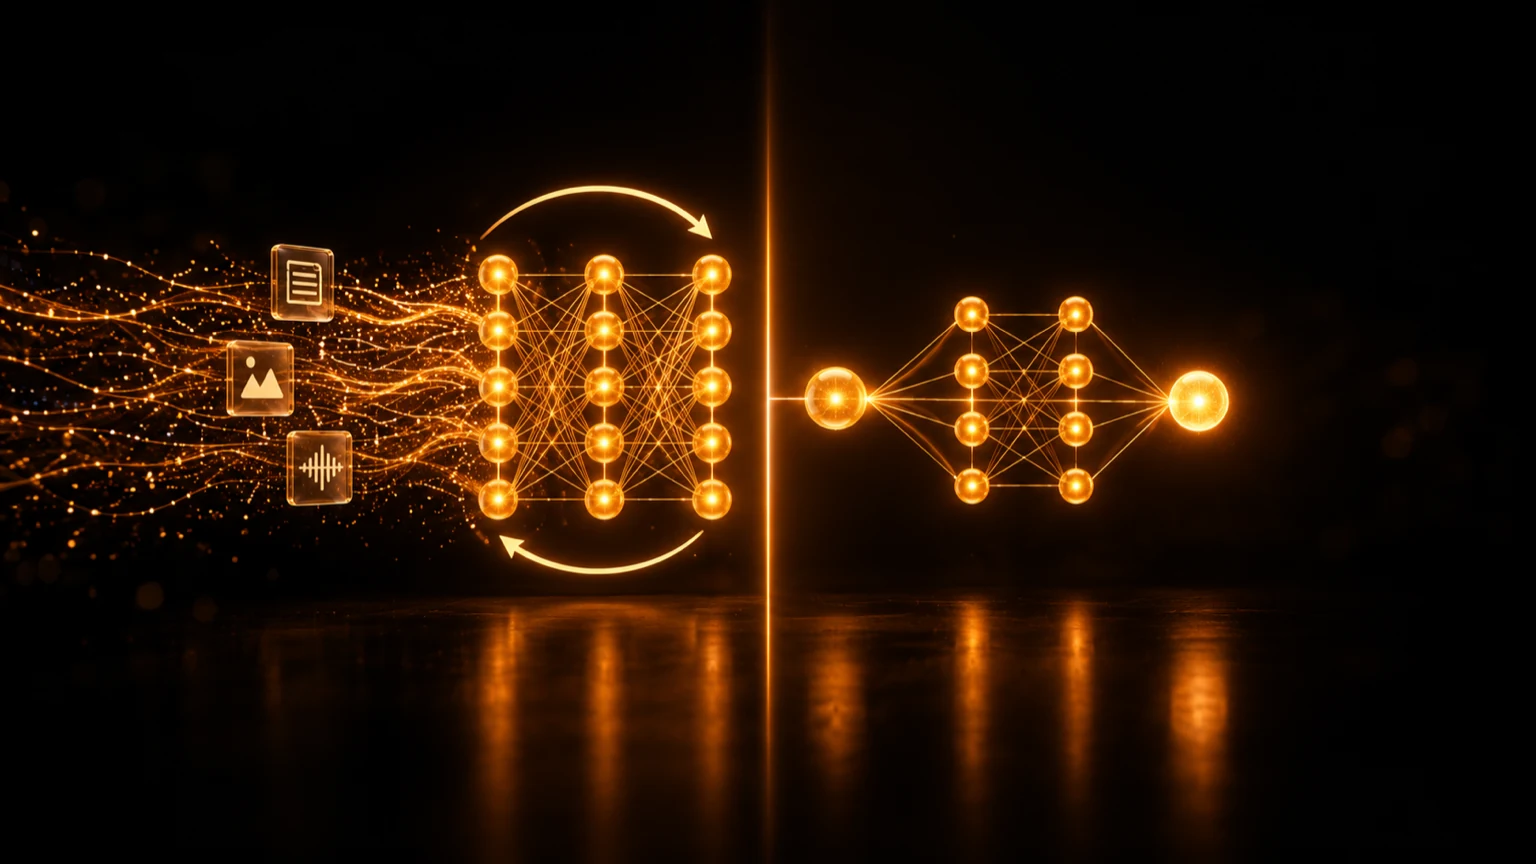
Обучение и инференс: в чем разница?
AI-модели обычно выполняют два очень разных вида работы: обучение (training) и инференс (inference).
Если коротко, обучение — это учеба на данных, а инференс — применение выученного.
Во время обучения модель меняет свои внутренние параметры, чтобы лучше справляться с задачей.
Во время инференса обученная модель получает новые входные данные и выдает результат, обычно не меняя выученных параметров.
Если сравнить обучение с подготовкой к экзамену, то инференс — это ответ на новый вопрос с помощью того, что вы выучили.
Что происходит во время обучения?
Обучение — это этап, на котором модель изучает закономерности в данных.
Допустим, мы хотим научить модель определять, есть ли на изображении кошка. Вначале ее прогнозы могут быть неточными: увидев кошку, модель может оценить вероятность того, что на снимке кошка, всего в 20%.
Процесс обучения сравнивает прогноз с правильным ответом и вычисляет ошибку, которую часто выражают величиной loss, или функцией потерь.
Упрощенно цикл обучения выглядит так:
- Модель получает примеры из обучающих данных.
- Делает прогноз.
- Прогноз сравнивается с правильным ответом.
- Вычисляется loss.
- Обратное распространение ошибки (backpropagation) определяет, какой вклад каждый вес внес в ошибку.
- Веса модели обновляются.
- Цикл повторяется.
Ключевой шаг — обновление весов.
Нейронная сеть может содержать миллионы или миллиарды настраиваемых параметров, которые обычно называют весами. Обучение постепенно изменяет их так, чтобы модель давала более качественные результаты. Подробнее о loss, весах и обратном распространении ошибки мы рассказали в статье «Что такое нейронная сеть?»
Этот процесс может повторяться на очень большом наборе данных, иногда много раз.
Что происходит во время инференса?
Инференс начинается после того, как модель обучена.
Теперь задача не в том, чтобы улучшить модель, а в том, чтобы использовать ее. Покажите обученной модели новое изображение, и она может ответить: «Кошка: 97%».
Модель использует веса, выученные во время обучения, чтобы обработать новые входные данные и вернуть прогноз, классификацию, сгенерированный ответ, транскрипцию, изображение или другой результат.
При обычном инференсе нет ни обратного распространения ошибки, ни обновления весов. Входные данные просто проходят через слои обученной модели вперед — это называется прямым проходом (forward pass) — и на выходе получается результат.
Каждый раз, когда чат-бот генерирует ответ, STT-система расшифровывает новое аудио или модель генерации изображений создает картинку, выполняется инференс.
Обучение и инференс кратко
| Обучение | Инференс | |
|---|---|---|
| Цель | Научить модель | Использовать обученную модель |
| Вход | Обучающие примеры | Новые реальные данные |
| Веса | Обновляются снова и снова | Обычно остаются неизменными |
| Основные вычисления | Прямой и обратный проход | Прямой проход |
| Приоритет | Эффективное и точное обучение | Быстрый, стабильный и экономичный ответ |
| Типичная нагрузка | Крупные задачи обучения | Повторяющиеся запросы пользователей и приложений |
На обоих этапах может использоваться одна и та же архитектура модели, но цели у них разные.
Почему обучение обычно требует больше вычислений?
Обучение выполняет дополнительную работу.
Модель не только вычисляет результат. Она также измеряет ошибку, передает информацию о ней назад по сети, вычисляет градиенты и обновляет огромное количество параметров.
Поэтому обучение часто требует:
- больших наборов данных;
- значительных ресурсов GPU или других ускорителей;
- большого объема памяти;
- многократных проходов по данным;
- длительных распределенных запусков для крупных моделей.
Очень большие модели обучают сразу на множестве ускорителей. Поэтому обучение модели с нуля бывает дорогим и долгим.
Но это не означает, что инференс всегда дешев.
Если модель ежедневно обслуживает миллионы запросов, инференс превращается в постоянную нагрузку в production. За время жизни популярного продукта он может потребить огромные вычислительные ресурсы, хотя один запрос намного меньше полного цикла обучения.
Что важно во время инференса?
Инференс — этап, на котором пользователи напрямую работают с обученной моделью, поэтому меняются и инженерные приоритеты.
Часто важны:
- задержка (latency): как быстро пользователь получает результат одного запроса;
- пропускная способность (throughput): сколько запросов или токенов система обрабатывает за определенное время;
- память: насколько эффективно модель помещается на доступном оборудовании;
- стоимость: сколько стоит обработать один запрос, токен, изображение или минуту аудио;
- надежность: насколько стабильно система работает под реальной нагрузкой.
Для интерактивного чат-бота модель, которая дает отличный ответ, но начинает отвечать только через минуту, может испортить впечатление от продукта.
В системе пакетной транскрипции, которая ночью обрабатывает тысячи записей, небольшая задержка для одного файла может быть куда менее важна, чем общая пропускная способность и стоимость.
Поэтому единственной «лучшей» настройки инференса не существует: все зависит от продукта.
Простой пример с LLM
Большие языковые модели особенно наглядно показывают разницу.
Во время обучения
Модель получает большие объемы текста и изучает статистические закономерности языка. Снова и снова она предсказывает следующий токен, измеряет ошибку прогноза и обновляет миллиарды параметров.
Со временем в параметрах модели закрепляются полезные закономерности языка и обучающих данных.
Во время инференса
Пользователь отправляет запрос (prompt):
«Объясни фотосинтез двумя предложениями.»
Обученная LLM обрабатывает запрос и пишет ответ по одному токену: каждый новый токен добавляется к тексту, и модель предсказывает следующий, пока ответ не будет готов.
Модель применяет то, чему научилась во время обучения. Обычно она не переобучается на самом этом запросе.
Поэтому простой вопрос к модели — это инференс, а не обучение.
А что такое fine-tuning?
Fine-tuning, или дообучение, — это тоже обучение.
Вместо обучения модели с нуля разработчики берут уже обученную модель и продолжают обучать ее на новых или более специализированных данных. Общая модель, дообученная на специализированном датасете, становится fine-tuned моделью.
Fine-tuning помогает адаптировать модель к определенному языку, области, стилю, задаче или требованиям продукта.
После того как дообучение завершено и обновленная модель развернута, запросы к ней снова являются инференсом.
Поэтому обучение, fine-tuning, инференс и развертывание не стоит считать взаимозаменяемыми терминами.
Пример с голосовым AI
Голосовой AI делает разницу особенно наглядной.
Возьмем модель speech-to-text, которая превращает речь в текст.
Во время обучения модель может учиться на множестве часов речи с соответствующими расшифровками. Ее параметры обновляются, чтобы она лучше сопоставляла звуковые закономерности с текстом.
Во время инференса пользователь записывает новое голосовое сообщение. Обученная STT-модель получает новое аудио и возвращает его расшифровку.
Тот же принцип работает и для text-to-speech. TTS-модель изучает речевые закономерности во время обучения, а во время инференса получает новый текст и генерирует аудио.
В NeuronAI сервисы Speech-to-Text, Text-to-Speech и приложения на базе языковых моделей тоже опираются на это разделение: модели сначала разрабатывают, обучают или адаптируют, а затем развертывают, чтобы пользователи могли выполнять инференс на новом тексте или аудио.
Пользователь видит результат. Основное обучение произошло раньше.
Почему одна и та же модель может по-разному работать в production?
Хорошо обучить модель — лишь часть создания полезного AI-продукта.
Когда модель переходит к инференсу, важной становится и окружающая ее система.
Одна и та же модель может отличаться по скорости, расходу памяти и стоимости в зависимости от:
- оборудования;
- числовой точности;
- размера batch;
- программного обеспечения для инференса;
- квантизации модели;
- того, как планируются запросы;
- объема обрабатываемого контекста.
Например, квантизация (quantization) позволяет хранить веса модели меньшим числом бит. Это часто снижает расход памяти и может сделать инференс быстрее или дешевле. Конкретный компромисс между качеством и производительностью зависит от модели и метода.
Поэтому развертывание AI — отдельная инженерная задача. Модель может хорошо показать себя в исследовательских тестах, но потребовать серьезной оптимизации, прежде чем станет практичной для тысяч реальных пользователей.
Означает ли инференс, что модель никогда не меняется?
Обычно сам инференс не обновляет веса модели.
Но production-система AI со временем может улучшаться.
Разработчики могут:
- собрать новые данные, которые разрешено использовать для обучения;
- оценить, где модель работает плохо;
- обучить или дообучить новую версию;
- протестировать ее;
- развернуть обновленную модель для инференса.
Затем цикл начинается снова: инференс, оценка, улучшение данных или обучения и новое обучение.
Обучение и инференс — отдельные этапы, но реальные AI-системы могут проходить через них многократно.
Самый простой способ запомнить
Если запомнить только одно различие, пусть это будет:
Обучение изменяет модель. Инференс использует модель.
При обучении данные поступают в модель, она учится, и ее веса обновляются. При инференсе на вход поступают новые данные, обученные веса остаются прежними, и на выходе получается результат.
Оба этапа необходимы.
Без обучения модель не освоит задачу. Без инференса обученная модель фактически не используется.
Понимание этой разницы облегчает и многие другие темы AI — от GPU и развертывания моделей до fine-tuning, задержки, токенов и стоимости работы AI-продуктов в большом масштабе.