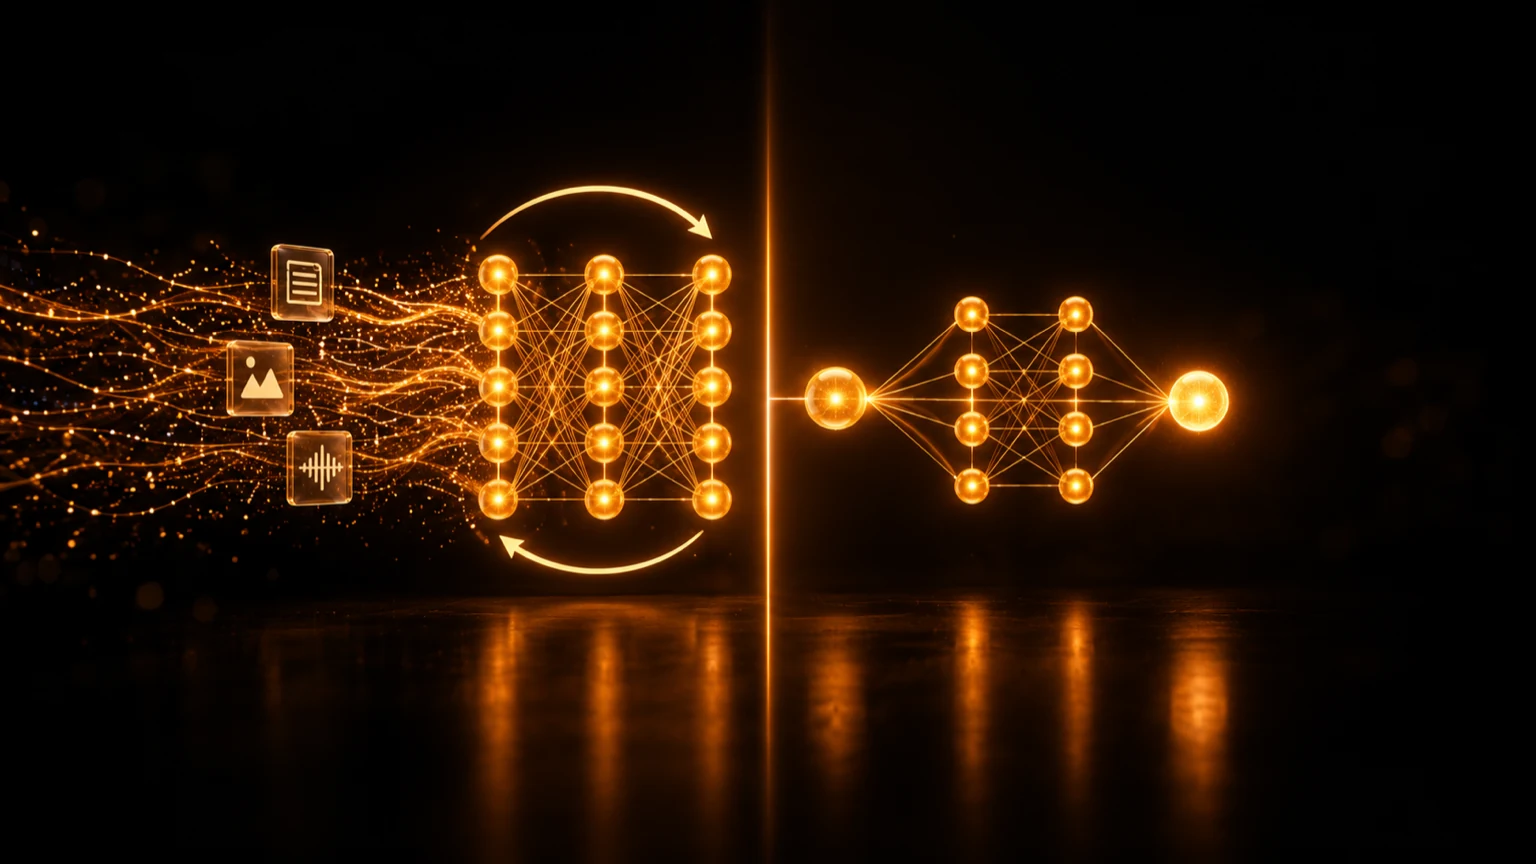
Training vs inference: айырмашылығы неде?
AI модельдері әдетте екі түрлі жұмыс кезеңінен өтеді: training (оқыту) және inference.
Қысқаша айтқанда, training — деректерден үйрену, ал inference — үйренгенді қолдану.
Training кезінде модель тапсырманы жақсырақ орындау үшін өзінің ішкі параметрлерін өзгертеді.
Inference кезінде оқытылған модель жаңа кіріс дерегін қабылдап, әдетте үйренген параметрлерін өзгертпей нәтиже шығарады.
Training-ті емтиханға дайындалу деп елестетсек, inference — үйренген білімді жаңа сұраққа жауап беру үшін қолдану.
Training кезінде не болады?
Training — модель деректерден заңдылықтарды үйренетін кезең.
Мысалы, суретте мысық бар-жоғын анықтайтын модель үйреткіміз келеді. Алғашқыда модельдің болжамдары нашар болуы мүмкін: мысық суретін көріп, онда мысық бар екенінің ықтималдығын небәрі 20% деп бағалауы мүмкін.
Оқыту процесі бұл болжамды дұрыс жауаппен салыстырып, қатені есептейді. Қате көбіне loss деп аталатын шамамен көрсетіледі.
Оқыту циклі жеңілдетілген түрде былай көрінеді:
- Модель оқыту деректерінен мысалдар алады.
- Болжам жасайды.
- Болжам дұрыс жауаппен салыстырылады.
- Loss есептеледі.
- Backpropagation әр салмақтың қатеге қаншалықты әсер еткенін анықтайды.
- Модель салмақтары жаңартылады.
- Цикл қайталанады.
Ең маңызды қадам — салмақтарды жаңарту.
Нейрондық желіде миллиондаған немесе миллиардтаған реттелетін параметр болуы мүмкін. Олар әдетте салмақтар деп аталады. Training осы салмақтарды біртіндеп өзгертіп, модель нәтижесін жақсартады. Loss, салмақтар және backpropagation туралы «Нейрондық желі деген не?» мақаласында толығырақ жаздық.
Бұл процесс өте үлкен деректер жиынында, кейде көп рет қайталанады.
Inference кезінде не болады?
Inference модель оқытылғаннан кейін басталады.
Енді мақсат — модельді жақсарту емес, оны пайдалану. Оқытылған модельге жаңа сурет берсеңіз, ол «Мысық: 97%» деп жауап беруі мүмкін.
Модель training кезінде үйренген салмақтарын пайдаланып, жаңа кірісті өңдейді және болжам, жіктеу, генерацияланған жауап, транскрипция, сурет немесе басқа нәтиже береді.
Қалыпты inference кезінде backpropagation да, салмақтарды жаңарту да болмайды. Кіріс дерегі оқытылған модельдің қабаттарынан тек алға қарай өтеді — мұны forward pass деп атайды — және шығыста нәтиже пайда болады.
Чат-бот жауап жасаған сайын, STT жүйесі жаңа аудионы мәтінге айналдырғанда немесе сурет генерациялау моделі жаңа сурет жасағанда модель inference орындайды.
Training vs inference қысқаша
| Training | Inference | |
|---|---|---|
| Мақсат | Модельді үйрету | Оқытылған модельді қолдану |
| Кіріс | Оқыту мысалдары | Жаңа нақты деректер |
| Салмақтар | Қайта-қайта жаңартылады | Әдетте өзгермейді |
| Негізгі есептеу | Forward pass + backward pass | Forward pass |
| Басымдық | Тиімді әрі дәл үйрену | Жылдам, тұрақты және үнемді жауап |
| Әдеттегі жүктеме | Ірі оқыту жұмыстары | Қолданушылар мен қолданбалардан келетін қайталанатын сұраулар |
Екі кезеңде де бір модель архитектурасы қолданылуы мүмкін, бірақ олардың мақсаты әртүрлі.
Неліктен training әдетте көбірек есептеуді қажет етеді?
Training қосымша жұмыс атқарады.
Модель тек нәтиже есептеп қоймайды. Ол қатені өлшейді, қате туралы ақпаратты желі бойымен кері өткізеді, градиенттерді есептейді және көптеген параметрді жаңартады.
Сондықтан training жиі мыналарды қажет етеді:
- үлкен деректер жиындары;
- айтарлықтай GPU немесе басқа үдеткіш ресурстары;
- көп жад;
- деректер бойынша бірнеше рет өту;
- үлкен модельдер үшін ұзақ уақыт жүретін үлестірілген есептеулер.
Өте үлкен модельдерді оқытуда көптеген үдеткіш бірге жұмыс істейді. Сол себепті модельді нөлден оқыту қымбат әрі ұзақ болуы мүмкін.
Бірақ бұл inference әрқашан арзан дегенді білдірмейді.
Егер модель күн сайын миллиондаған сұрауға қызмет көрсетсе, inference үздіксіз production жүктемесіне айналады. Бір сұрау толық оқыту циклінен әлдеқайда кіші болса да, танымал өнімнің бүкіл жұмыс мерзімінде inference орасан зор есептеу ресурстарын жұмсауы мүмкін.
Inference кезінде не маңызды?
Inference — қолданушылар оқытылған модельмен тікелей жұмыс істейтін кезең, сондықтан инженерлік басымдықтар да өзгереді.
Көбіне мыналар маңызды:
- latency: бір сұраудың нәтижесі қаншалықты тез келеді;
- throughput: жүйе белгілі бір уақытта қанша сұрау немесе токен өңдей алады;
- жад: модель қолжетімді жабдыққа қаншалықты тиімді сыяды;
- құн: бір сұрауды, токенді, суретті немесе бір минут аудионы өңдеу қанша тұрады;
- сенімділік: жүйе нақты трафик кезінде қаншалықты тұрақты жұмыс істейді.
Интерактивті чат-бот үшін тамаша жауап беретін, бірақ жауап беруді бір минуттан кейін ғана бастайтын модель қолайсыз болуы мүмкін.
Түн ішінде мыңдаған аудио файлды өңдейтін пакеттік транскрипция жүйесінде бір файлдың сәл баяу өңделуі жалпы throughput пен шығынға қарағанда әлдеқайда аз маңызды болуы мүмкін.
Сондықтан inference үшін жалғыз «ең жақсы» баптау жоқ: бәрі өнімге байланысты.
Қарапайым LLM мысалы
Үлкен тілдік модельдер бұл айырмашылықты анық көрсетеді.
Training кезінде
Модель үлкен көлемдегі мәтінді көріп, тілдің статистикалық заңдылықтарын үйренеді. Ол қайта-қайта келесі токенді болжайды, болжам қатесін өлшейді және миллиардтаған параметрді жаңартады.
Уақыт өте келе модель параметрлерінде тіл мен оқыту деректеріндегі пайдалы заңдылықтар сақталады.
Inference кезінде
Қолданушы prompt жібереді:
«Фотосинтезді екі сөйлеммен түсіндір.»
Оқытылған LLM prompt-ты өңдеп, жауапты бір-бір токеннен жазады: әр жаңа токен мәтінге қосылады, ал модель жауап дайын болғанша келесісін болжайды.
Модель training кезінде үйренгенін қолданады. Әдетте ол сол prompt-тың өзінде қайта оқытылмайды.
Сондықтан модельге жай ғана сұрақ қою — training емес, inference.
Fine-tuning деген не?
Fine-tuning те training болып саналады.
Модельді нөлден оқытудың орнына әзірлеушілер алдын ала оқытылған модельді алып, оны жаңа немесе мамандандырылған деректерде әрі қарай оқытады. Жалпы модель мамандандырылған датасетте қосымша оқытылғаннан кейін fine-tuned модельге айналады.
Fine-tuning модельді белгілі бір тілге, салаға, стильге, тапсырмаға немесе өнім талабына бейімдеуге көмектеседі.
Fine-tuning аяқталып, жаңартылған модель deploy етілгеннен кейін оған келетін сұраулар қайтадан inference болып есептеледі.
Сондықтан training, fine-tuning, inference және deployment терминдерін бір-бірінің орнына қолдануға болмайды.
Дауыстық AI мысалы
Дауыстық AI бұл айырмашылықты іс жүзінде анық көрсетеді.
Сөйлеуді мәтінге айналдыратын speech-to-text моделін қарастырайық.
Training кезінде модель көп сағаттық сөйлеу жазбалары мен оларға сәйкес транскрипциялардан үйренуі мүмкін. Аудио заңдылықтарын мәтінмен жақсырақ сәйкестендіру үшін оның параметрлері жаңартылады.
Inference кезінде қолданушы жаңа дауыстық хабарлама жазады. Оқытылған STT моделі жаңа аудионы қабылдап, оның транскриптін қайтарады.
Дәл осы принцип text-to-speech үшін де қолданылады. TTS моделі training кезінде сөйлеу заңдылықтарын үйренеді, ал inference кезінде жаңа мәтінді қабылдап, аудио жасайды.
NeuronAI ұсынатын Speech-to-Text, Text-to-Speech және тілдік модельге негізделген қолданбалар да осы бөлініске сүйенеді: модельдер алдымен жасалады, оқытылады немесе бейімделеді, содан кейін қолданушылар жаңа мәтін немесе аудиомен inference жасай алуы үшін deploy етіледі.
Қолданушы нәтижені көреді. Үйренудің негізгі бөлігі одан әлдеқайда бұрын өткен.
Неліктен бір модель production-да әртүрлі жұмыс істеуі мүмкін?
Жақсы модельді оқыту — пайдалы AI өнімін жасаудың бір бөлігі ғана.
Модель inference кезеңіне өткенде, оны қоршаған жүйе де маңызды болады.
Бір модельдің жылдамдығы, жад шығыны және құны мыналарға байланысты өзгеруі мүмкін:
- жабдық (hardware);
- сандық дәлдік;
- batch size;
- inference бағдарламалық жасақтамасы;
- модельдің quantization-ы;
- сұрауларды жоспарлау;
- өңделетін контекст көлемі.
Мысалы, quantization модель салмақтарын азырақ битпен көрсетуге мүмкіндік береді. Бұл көбіне жад шығынын азайтып, inference-ті жылдамырақ немесе арзанырақ етеді. Сапа мен өнімділік арасындағы нақты ымыра модель мен әдіске байланысты.
Сондықтан AI deployment — өз алдына бөлек инженерлік міндет. Модель зерттеу тесттерінде жақсы нәтиже көрсетсе де, мыңдаған нақты қолданушыға жарамды болуы үшін айтарлықтай оңтайландыруды қажет етуі мүмкін.
Inference модель ешқашан өзгермейді дегенді білдіре ме?
Әдетте inference процесінің өзі модель салмақтарын жаңартпайды.
Бірақ production AI жүйесі уақыт өте келе жақсара алады.
Әзірлеушілер:
- рұқсат етілген жаңа оқыту деректерін жинай алады;
- модельдің қай жерде нашар жұмыс істейтінін бағалай алады;
- жаңа нұсқаны оқыта немесе fine-tune ете алады;
- оны тестілей алады;
- жаңартылған модельді inference үшін deploy ете алады.
Содан кейін цикл қайта басталады: inference, бағалау, деректерді немесе оқытуды жақсарту және қайта training.
Training мен inference — бөлек кезеңдер, бірақ нақты AI жүйелері олардың арасында бірнеше рет айналуы мүмкін.
Есте сақтаудың ең оңай жолы
Егер бір ғана айырмашылықты есте сақтасаңыз, мынау болсын:
Training модельді өзгертеді. Inference модельді қолданады.
Training кезінде деректер модельге беріледі, модель үйренеді және салмақтары жаңартылады. Inference кезінде жаңа кіріс беріледі, оқытылған салмақтар өзгермейді және шығыста нәтиже алынады.
Екеуі де қажет.
Training болмаса, модель тапсырманы үйренбейді. Inference болмаса, оқытылған модель іс жүзінде қолданылмайды.
Бұл айырмашылықты түсіну GPU, модель deployment, fine-tuning, latency, токендер және AI өнімдерін үлкен масштабта іске қосу құны сияқты басқа ұғымдарды да оңайырақ түсінуге көмектеседі.