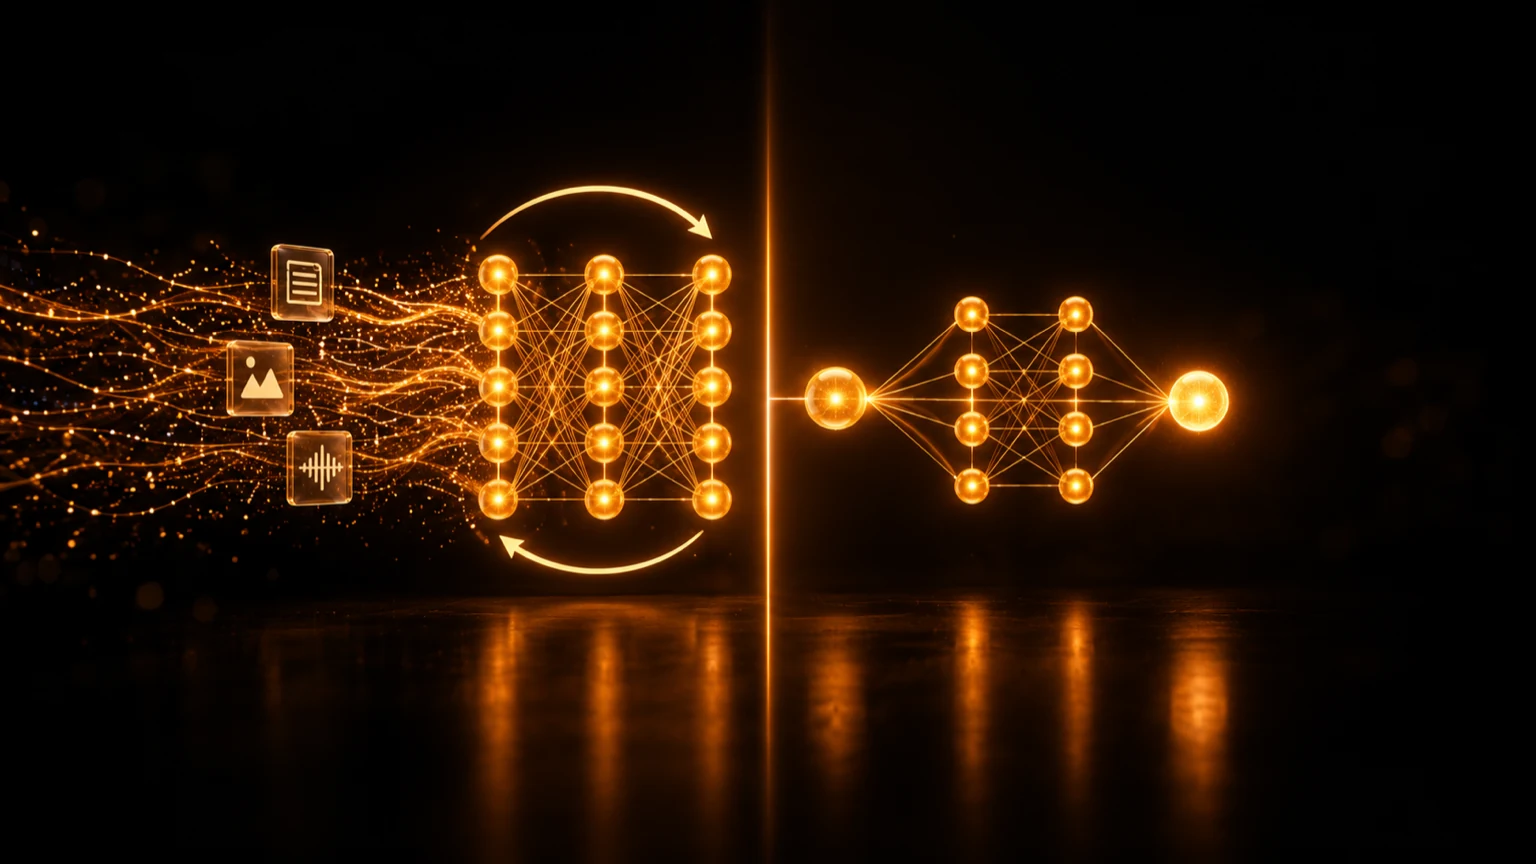
Training va inference: farqi nimada?
AI modellari odatda ikki xil ishni bajaradi: training (oʻqitish) va inference.
Qisqa qilib aytganda, training — maʼlumotlardan oʻrganish, inference esa oʻrganilgan bilimdan foydalanish.
Training vaqtida model vazifani yaxshiroq bajarish uchun ichki parametrlarini oʻzgartiradi.
Inference vaqtida esa oʻqitilgan model yangi kirish maʼlumotini qabul qiladi va odatda oʻrgangan parametrlarini oʻzgartirmasdan natija chiqaradi.
Trainingni imtihonga tayyorlanish deb tasavvur qilsak, inference — oʻrganganlarni yangi savolga javob berishda qoʻllash.
Training vaqtida nima sodir boʻladi?
Training — model maʼlumotlardan qonuniyatlarni oʻrganadigan bosqich.
Masalan, tasvirda mushuk bor-yoʻqligini aniqlaydigan model oʻqitmoqchimiz. Dastlab uning bashoratlari yomon boʻlishi mumkin: mushuk rasmini koʻrib, unda mushuk borligi ehtimolini atigi 20% deb baholashi mumkin.
Training jarayoni bu bashoratni toʻgʻri javob bilan solishtiradi va xatoni hisoblaydi. Xato koʻpincha loss deb ataladigan qiymat bilan ifodalanadi.
Soddalashtirilgan training sikli quyidagicha:
- Model oʻqitish maʼlumotlaridan misollar oladi.
- Bashorat qiladi.
- Bashorat toʻgʻri javob bilan solishtiriladi.
- Loss hisoblanadi.
- Backpropagation har bir vaznning xatoga qanchalik taʼsir qilganini aniqlaydi.
- Model vaznlari yangilanadi.
- Sikl takrorlanadi.
Eng muhim qadam — vaznlarni yangilash.
Neyron tarmoqda millionlab yoki milliardlab sozlanadigan parametr boʻlishi mumkin. Ular odatda vaznlar deb ataladi. Training shu vaznlarni asta-sekin oʻzgartirib, model natijalarini yaxshilaydi. Loss, vaznlar va backpropagation haqida “Neyron tarmoq nima?” maqolasida batafsil yozganmiz.
Bu jarayon juda katta maʼlumotlar toʻplami ustida, baʼzan koʻp marta takrorlanadi.
Inference vaqtida nima sodir boʻladi?
Inference model oʻqitilgandan keyin boshlanadi.
Endi maqsad modelni yaxshilash emas, undan foydalanish. Oʻqitilgan modelga yangi rasm bersangiz, u “Mushuk: 97%” deb javob qaytarishi mumkin.
Model training vaqtida oʻrgangan vaznlari yordamida yangi kirish maʼlumotini qayta ishlaydi va bashorat, klassifikatsiya, matn, transkripsiya, tasvir yoki boshqa natija qaytaradi.
Oddiy inference vaqtida backpropagation ham, vaznlarni yangilash ham boʻlmaydi. Kirish maʼlumoti oʻqitilgan model qatlamlaridan faqat oldinga qarab oʻtadi — bu forward pass deyiladi — va chiqishda natija hosil boʻladi.
Chatbot har safar javob yozganda, STT tizimi yangi audioni matnga aylantirganda yoki tasvir modeli yangi rasm yaratganda model inference bajaradi.
Training va inference qisqacha
| Training | Inference | |
|---|---|---|
| Maqsad | Modelni oʻrgatish | Oʻqitilgan modeldan foydalanish |
| Kirish | Oʻqitish misollari | Yangi, real maʼlumot |
| Vaznlar | Qayta-qayta yangilanadi | Odatda oʻzgarmaydi |
| Asosiy hisoblash | Forward pass + backward pass | Forward pass |
| Ustuvorlik | Samarali va aniq oʻrganish | Tez, barqaror va tejamkor javob |
| Odatdagi yuklama | Katta training jarayonlari | Foydalanuvchi va ilovalardan keladigan takroriy soʻrovlar |
Ikkala bosqichda ham bir xil model arxitekturasi ishlatilishi mumkin, ammo ularning maqsadi har xil.
Nega training odatda koʻproq hisoblash talab qiladi?
Training qoʻshimcha ish bajaradi.
Model faqat natijani hisoblab qolmaydi. U xatoni oʻlchaydi, xato haqidagi maʼlumotni tarmoq boʻylab orqaga uzatadi, gradientlarni hisoblaydi va juda koʻp parametrni yangilaydi.
Shuning uchun training koʻpincha quyidagilarni talab qiladi:
- katta maʼlumotlar toʻplami;
- katta GPU yoki boshqa akselerator quvvati;
- koʻp xotira;
- maʼlumotlar ustidan qayta-qayta oʻtish;
- katta modellar uchun uzoq davom etadigan taqsimlangan hisoblash.
Juda katta modellarni oʻqitishda koʻplab akseleratorlar birga ishlaydi. Shu sababli modelni noldan oʻqitish qimmat va uzoq jarayon boʻlishi mumkin.
Ammo bu inference har doim arzon degani emas.
Agar model har kuni millionlab soʻrovga xizmat qilsa, inference doimiy production yuklamaga aylanadi. Bitta soʻrov toʻliq training jarayonidan ancha kichik boʻlsa ham, mashhur mahsulot ishlagan butun davr mobaynida inference juda katta hisoblash resurslarini sarflashi mumkin.
Inference vaqtida nimalar muhim?
Inference — foydalanuvchilar oʻqitilgan model bilan bevosita ishlaydigan bosqich, shuning uchun muhandislik ustuvorliklari ham oʻzgaradi.
Koʻpincha quyidagilar muhim:
- latency: bitta soʻrovga javob qancha tez keladi;
- throughput: tizim maʼlum vaqt ichida nechta soʻrov yoki tokenni qayta ishlay oladi;
- xotira: model mavjud qurilmaga qanchalik samarali sigʻadi;
- narx: bitta soʻrov, token, tasvir yoki bir daqiqa audioni qayta ishlash qancha turadi;
- barqarorlik: real trafik ostida tizim qanchalik ishonchli ishlaydi.
Interaktiv chatbot uchun juda yaxshi javob beradigan, ammo javob berishni faqat bir daqiqadan keyin boshlaydigan model noqulay boʻlishi mumkin.
Minglab audio fayllarni tunda qayta ishlaydigan batch transkripsiya tizimida esa bitta faylning biroz sekinroq ishlanishi umumiy throughput va xarajatga qaraganda ancha kam ahamiyatga ega boʻlishi mumkin.
Shuning uchun inference uchun yagona “eng yaxshi” sozlama yoʻq: hammasi mahsulotga bogʻliq.
Oddiy LLM misoli
Katta til modellari bu farqni juda yaxshi koʻrsatadi.
Training vaqtida
Model katta hajmdagi matnlarni koʻradi va tilning statistik qonuniyatlarini oʻrganadi. U qayta-qayta keyingi tokenni bashorat qiladi, bashorat xatosini oʻlchaydi va milliardlab parametrni yangilaydi.
Vaqt oʻtishi bilan model parametrlari til va oʻqitish maʼlumotlaridagi foydali qonuniyatlarni oʻzida saqlay boshlaydi.
Inference vaqtida
Foydalanuvchi prompt yuboradi:
“Fotosintezni ikki gapda tushuntirib ber.”
Oʻqitilgan LLM promptni qayta ishlaydi va javobni tokenma-token yozadi: har bir yangi token matnga qoʻshiladi, model esa javob tayyor boʻlguncha keyingisini bashorat qiladi.
Model training vaqtida oʻrganganlarini qoʻllaydi. Odatda u shu promptning oʻzida qayta oʻqitilmaydi.
Shuning uchun modelga oddiy savol berish — training emas, inference.
Fine-tuning nima?
Fine-tuning ham training hisoblanadi.
Modelni noldan oʻqitish oʻrniga dasturchilar oldindan oʻqitilgan modelni olib, uni yangi yoki ixtisoslashgan maʼlumotlarda yana oʻqitadi. Umumiy model ixtisoslashgan dataset ustida qoʻshimcha oʻqitilgach, fine-tuned modelga aylanadi.
Fine-tuning modelni maʼlum bir til, soha, uslub, vazifa yoki mahsulot talabiga moslashtirishga yordam beradi.
Fine-tuning tugab, yangilangan model deploy qilingach, unga keladigan soʻrovlar yana inference hisoblanadi.
Shuning uchun training, fine-tuning, inference va deployment atamalarini bir-birining oʻrnida ishlatib boʻlmaydi.
Ovozli AI misoli
Ovozli AI bu farqni amalda yaqqol koʻrsatadi.
Nutqni matnga aylantiradigan speech-to-text modelini olaylik.
Training vaqtida model koʻp soatlik nutq yozuvlari va ularning transkriptlaridan oʻrganishi mumkin. Audio qonuniyatlarini matnga yaxshiroq moslashtirishi uchun uning parametrlari yangilanadi.
Inference vaqtida esa foydalanuvchi yangi ovozli xabar yozadi. Oʻqitilgan STT modeli yangi audioni qabul qilib, uning transkriptini qaytaradi.
Xuddi shu tamoyil text-to-speech uchun ham amal qiladi. TTS modeli training vaqtida nutq qonuniyatlarini oʻrganadi, inference vaqtida esa yangi matnni qabul qilib, audio yaratadi.
NeuronAIdagi Speech-to-Text, Text-to-Speech va til modellariga asoslangan ilovalar ham shu ajratishga tayanadi: modellar avval ishlab chiqiladi, oʻqitiladi yoki moslashtiriladi, soʻng foydalanuvchilar yangi matn yoki audio bilan inference bajarishi uchun deploy qilinadi.
Foydalanuvchi natijani koʻradi. Oʻrganishning asosiy qismi esa undan ancha oldin boʻlib oʻtgan.
Nega bir xil model productionda turlicha ishlashi mumkin?
Yaxshi modelni oʻqitish — foydali AI mahsulotini yaratishning faqat bir qismi.
Model inference bosqichiga oʻtgach, uning atrofidagi tizim ham katta ahamiyatga ega boʻladi.
Bir xil modelning tezligi, xotira sarfi va narxi quyidagilarga qarab farq qilishi mumkin:
- qurilma (hardware);
- sonlarning aniqlik formati;
- batch size;
- inference dasturiy taʼminoti;
- modelni quantization qilish;
- soʻrovlarni rejalashtirish;
- qayta ishlanadigan kontekst hajmi.
Masalan, quantization model vaznlarini kamroq bit bilan ifodalash imkonini beradi. Bu koʻpincha xotira sarfini kamaytiradi va inferenceni tezroq yoki arzonroq qiladi. Sifat va unumdorlik oʻrtasidagi aniq muvozanat esa model va usulga bogʻliq.
Shuning uchun AI deployment — alohida muhandislik vazifasi. Model tadqiqot testlarida yaxshi natija koʻrsatsa ham, minglab real foydalanuvchiga xizmat qilishi uchun jiddiy optimallashtirishni talab qilishi mumkin.
Inference modelning hech qachon oʻzgarmasligini anglatadimi?
Odatda inference jarayonining oʻzi model vaznlarini yangilamaydi.
Ammo production AI tizimi vaqt oʻtishi bilan yaxshilanib borishi mumkin.
Dasturchilar quyidagilarni qilishi mumkin:
- ruxsat etilgan yangi oʻqitish maʼlumotlarini toʻplash;
- model qayerda yomon ishlayotganini baholash;
- yangi versiyani oʻqitish yoki fine-tune qilish;
- uni sinovdan oʻtkazish;
- yangilangan modelni inference uchun deploy qilish.
Shundan soʻng sikl yana boshlanadi: inference, baholash, maʼlumot yoki trainingni yaxshilash va qayta training.
Training va inference alohida bosqichlar, ammo real AI tizimlari ular orasida qayta-qayta aylanishi mumkin.
Eslab qolishning eng oson yoʻli
Faqat bitta farqni eslab qolsangiz, shu boʻlsin:
Training modelni oʻzgartiradi. Inference modeldan foydalanadi.
Training vaqtida maʼlumot modelga beriladi, model oʻrganadi va vaznlari yangilanadi. Inference vaqtida esa yangi kirish maʼlumoti beriladi, oʻqitilgan vaznlar oʻzgarmaydi va chiqishda natija olinadi.
Ikkalasi ham zarur.
Trainingsiz model vazifani oʻrganmaydi. Inferencesiz esa oʻqitilgan model amalda ishlatilmaydi.
Bu farqni tushunish GPU, model deploymenti, fine-tuning, latency, tokenlar va AI mahsulotlarini katta miqyosda ishlatish xarajati kabi boshqa tushunchalarni anglashni ham osonlashtiradi.